Jack Dorsey’den Sadece Sesle Öğrenen Yapay Zeka: Dessa
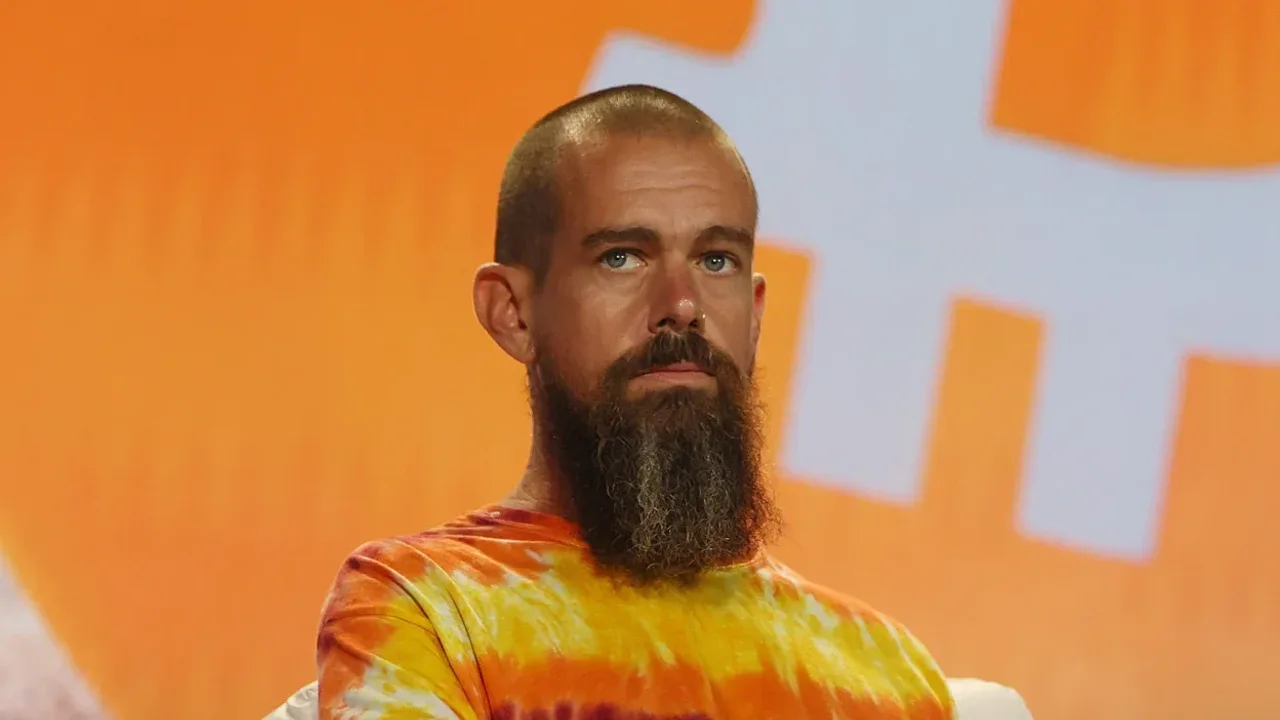
Twitter’ın kurucu ortaklarından Jack Dorsey’nin yönettiği Block, insanlarla daha doğal ve gerçek zamanlı konuşmalar gerçekleştirmek üzere tasarlanan Dessa yapay zeka modeli ile teknoloji dünyasında dikkatleri üzerine çekiyor. Şirketin paylaştığı bilgilere göre bu yeni model, metin verileri veya önceden eğitilmiş herhangi bir sistem kullanılmadan, tamamen insan konuşmalarından sıfırdan eğitildi.
Geleneksel sesli asistanların aksine Dessa, metne ihtiyaç duymadan doğrudan ses girdisiyle çalışıp ses çıktısı üreten bir mimariye sahip. Bu yaklaşım, modelin dili tıpkı insanların yaptığı gibi yalnızca dinleyerek öğrenmesini sağlıyor.
Metin Verisi Kullanmadan Eğitilen Bir Mimari
Günümüzde kullanılan çoğu sesli yapay zeka sistemi, kullanıcının konuşmasını önce metne dönüştürüyor, ardından bu metni işleyerek bir yanıt oluşturuyor ve son olarak yanıtı yeniden sese çeviriyor. Bu karmaşık süreçte konuşmanın tonu, duygusal nüansları ve doğal ritmi gibi kritik ayrıntılar çoğu zaman kaybolabiliyor.
We made the first AI model you can have a realistic conversation with that was trained entirely on speech!
Dessa is a full-duplex speech-to-speech model that you can run on consumer GPUs.
This is a GPT3 moment for speech. https://t.co/XVD8sSyJn8
— Ragavan Thurairatnam (@RagavanThurair) October 23, 2026
Block tarafından geliştirilen Dessa ise doğrudan ses girdisiyle çalışıp ses çıktısı üreten özel bir mimariye sahip. Şirket, modelin eğitiminde herhangi bir metin verisi veya önceden eğitilmiş bir model kullanılmadığını özellikle vurguluyor.
Böylece Dessa’nın, insanların dili yalnızca dinleyerek öğrenmesine benzer bir yaklaşımla geliştirildiği ifade ediliyor. Bu yöntem, modelin insan konuşmasındaki doğal akışı daha iyi kavramasına olanak tanıyor.
Sistem, konuşma sırasında ortaya çıkan duygusal tonlamaları ve ritmik değişimleri doğrudan ses üzerinden analiz edebiliyor. Bu durum, yapay zekanın kullanıcıya çok daha doğal ve insansı bir etkileşim sunmasını mümkün kılıyor.
Full-Duplex Teknolojisi ve Gerçek Zamanlı Etkileşim
Dessa’nın öne çıkan en önemli özelliklerinden biri, full-duplex olarak adlandırılan çalışma biçimi. Bu teknoloji sayesinde model, kullanıcı konuşmasını bitirene kadar beklemek yerine aynı anda dinleyip konuşabiliyor.
Kullanıcı sözünü kestiğinde tepki verebilmesi, konuşma sırasında kısa geri bildirimler sunabilmesi ve karşılıklı diyaloğun ritmine uyum sağlaması hedefleniyor. Block’un yayımladığı örneklerde Dessa, sesli tahmin oyunları oynuyor, filmler hakkında sohbet ediyor ve OpenAI’ın GPT-Live-1 ses modeliyle konuşuyor.
Bazı demolar oldukça doğal bir etkileşim izlenimi verirken model zaman zaman konuştuğu kişiyi yanlış tanıyabiliyor veya konudan uzaklaşabiliyor. Dolayısıyla gösterimler, sistemin henüz kusursuz bir konuşma deneyimi sunmadığını da ortaya koyuyor.
Donanım Gereksinimleri ve Gelecek Planları
Block’un açıklamasına göre Dessa, M4 Max işlemcili MacBook Pro veya daha güçlü donanımlarda yerel olarak çalışabiliyor. Şirket, modelin çıkarım işlemlerini gerçek zamanlıdan daha hızlı gerçekleştirebildiğini de belirtiyor.
Bununla birlikte modelin boyutu, bağımsız performans testleri ve farklı donanımlardaki gecikme değerleri henüz açıklanmış değil. Dessa şimdilik araştırma ön izlemesi aşamasında bulunuyor.
Block, modeli öncelikle küçük bir yapay zeka güvenliği araştırmacısı grubunun erişimine sunmayı planlıyor. Bu kısıtlı erişim, modelin güvenliğinin ve performansının daha detaylı incelenmesini amaçlıyor.
Sizce sadece sesle eğitilen bu yeni nesil yapay zeka modelleri, gelecekte sesli asistanların yerini tamamen alabilir mi?
Yorumunuz gönderildi,
onaylandıktan sonra yayımlanacak.